Close Menu
    Najnovejše objave

    Huawei pospešuje prihod AI-čipa Ascend 960DT: lahko res ogrozi Nvidio?

    September 17, 2026

    AI startupi pred rokom za Disrupt 2026: tri dni za stik z vlagatelji in partnerji

    September 17, 2026

    AI agenta Instinct in Muse že kličeta namesto uporabnikov

    September 17, 2026
    • Demos
    • Buy Now
    Vse novice in druge informacije – Umetna inteligenca v Sloveniji
    Subscribe
    Thursday, September 17
    • Domov
    • Splošno o UI
    • Intervjuji s SLO podjetji
    • Generativna UI
    • UI za grafike
    • AI zakonodaja
    • Konference in dogodki o UI
    • Tedenski podcast o UI
    • Oglaševanje
    • O nas
    Vse novice in druge informacije – Umetna inteligenca v Sloveniji
    Home » Ko več spomina zmanjša pamet velikih jezikovnih modelov: pasti in priložnosti za LLM ter RAG

    Ko več spomina zmanjša pamet velikih jezikovnih modelov: pasti in priložnosti za LLM ter RAG

    Peter MesarecBy Peter MesarecJune 10, 2026Updated:June 11, 2026 No Comments3 Mins Read
    Ko več spomina zmanjša pamet velikih jezikovnih modelov: pasti in priložnosti za LLM ter RAG
    Ko več spomina zmanjša pamet velikih jezikovnih modelov: pasti in priložnosti za LLM ter RAG
    Share
    Facebook Twitter LinkedIn Pinterest Email

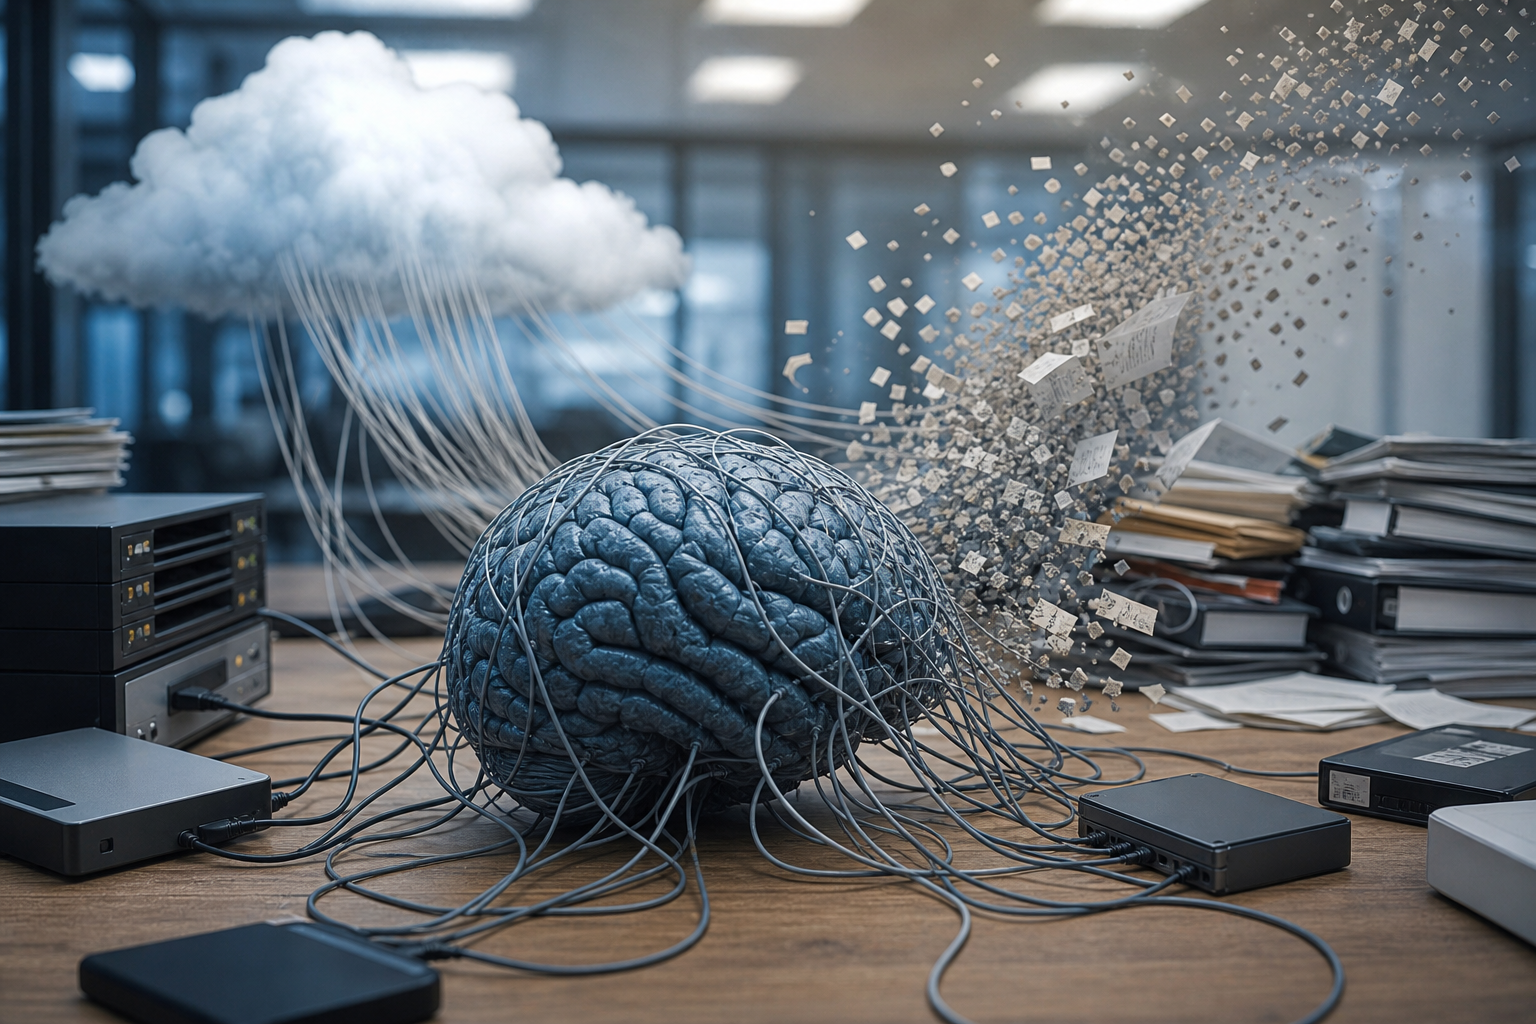
    Ali več spomina pomeni pametnejši velik jezikovni model? Najnovejši pristopi, kot je Retrieval-Augmented Generation (RAG), temeljijo na vse večjih in zmogljivejših orodjih za shranjevanje podatkov, vektorskih bazah in širših kontekstnih oknih. V teoriji naj bi ti sistemi okrepili sposobnost velikih jezikovnih modelov (LLM), da bolje razumejo vprašanja in hitreje najdejo odgovore. A praksa kaže, da lahko zanašanje na vse večje »spominske rezerve« prinese tudi nepričakovane težave, ki omejijo učinkovitost in celo zmanjšajo kakovost izhodov LLM-jev.
    Zakaj več spomina lahko zmanjša učinkovitost LLM-jev

    LLM-ji uporabljajo vektorske baze podatkov, razširjena kontekstna okna in RAG za shranjevanje in priklic ogromnih količin podatkov. Vendar se ob preveliki količini informacij pogosto pojavi pojav »informacijskega hrupa«: pomembni podatki se izgubijo med množico nepomembnih ali celo zastarelih informacij. LLM zato lažje spregleda ključno vprašanje ali napačno oceni, kateri podatki so relevantni. Podobno kot človek ob preobremenjenosti z informacijami izpusti bistvene podrobnosti, tudi LLM tvega, da se »utopi« v podatkih.

    Poleg tega lahko LLM zaradi prevelikega zanašanja na zunanje vire postane manj odziven in manj sposoben izkoriščati svoje osnovne sposobnosti razumevanja in sklepanja. Modeli včasih preprosto prepišejo ali povzamejo podatke iz baze, namesto da bi jih analizirali in ponudili dodano vrednost. Preobremenjeno kontekstno okno lahko pomeni, da ključni deli vprašanja izpadejo iz pozornosti modela.

    Kot primer: LLM, ki ima dostop do tisočih prejšnjih pogovorov, lahko na novo vprašanje odgovori s povprečenim ali nespecifičnim odgovorom, ker je njegov »spomin« prenasičen. Nasprotno lahko model s pametno selekcijo podatkov ponudi jedrnate, aktualne in personalizirane informacije.

    Konkretne prakse za pametno upravljanje spomina in etične posledice

    Za zagotovitev kakovostne uporabe spomina pri LLM-jih je ključno uvesti selektivno filtriranje, hierarhično shranjevanje ter strategije pozabljanja. Semantično razvrščanje omogoča, da model shrani le tiste informacije, ki so v določenem kontekstu res pomembne. Hierarhično shranjevanje omogoča ločevanje med kratkoročnim (npr. trenutna seja pogovora) in dolgoročnim spominom (npr. pogosto uporabljene informacije). Uvajanje funkcije »pozabljanja«, kjer se stari podatki po določenem času samodejno izbrišejo, pomaga preprečevati kopičenje nerelevantnih informacij.

    Podjetja lahko kot dober primer implementirajo sistem, kjer se po vsakem pogovoru uporabniški podatki samodejno razvrstijo glede na aktualnost in uporabnost. Občutljive informacije se po vnaprej določenem času izbrišejo, medtem ko se pogosti splošni odgovori shranijo za dolgoročno uporabo. Slab primer bi bil sistem, ki brez razlikovanja kopiči vse uporabniške interakcije, kar vodi do počasnega, neodzivnega in v skrajnem primeru celo varnostno tveganega modela.

    Obvladovanje »spomina« pri LLM-jih pa odpira tudi pomembna etična in varnostna vprašanja. Daljše shranjevanje podatkov povečuje tveganje za zlorabo ali razkritje osebnih informacij. Obstaja tveganje pristranskosti, saj se LLM lahko nauči iz pristranskih zgodovinskih podatkov. Poleg tega se pojavljajo vprašanja avtorskih pravic pri uporabi zunanjih baz znanja. Razvijalci in podjetja, ki gradijo rešitve na podlagi LLM in RAG, zato potrebujejo jasne politike upravljanja podatkov, dosledno spoštovanje zasebnosti in proaktivne ukrepe za zmanjšanje pristranskosti in zagotavljanje pravične uporabe znanja.

    Obeti za prihodnost so kljub izzivom spodbudni. Nova generacija inteligentnih agentov obljublja dinamično upravljanje spomina, kjer bodo modeli sproti ocenjevali relevantnost in varnost podatkov ter se učili iz lastnih napak. Z razvojem boljših algoritmov za upravljanje podatkov bosta transparentnost in zanesljivost LLM-jev še naprej rastli, zato bodo pametnejši spomin, večja varnost in pravičnost postali osnovni gradniki napredne umetne inteligence.

    ai agenti generativna umetna inteligenca poslovna uporaba ai umetna inteligenca
    Peter Mesarec

    Ustanovitelj SEOS AI, predavatelj in svetovalec o uporabi umetne inteligence v podjetjih.

    Keep Reading

    Treble z 18 milijoni dolarjev uči umetno inteligenco poslušati resnični svet

    Ko AI postane sodelavec: kdo bo v startupu še sprejemal odločitve?

    Snapova očala za 2.200 dolarjev stavijo na AI, ki naj bi vedela, kaj potrebujete prej kot vi

    Al Gore: Pravo tveganje umetne inteligence niso podatkovni centri, ampak modeli sami

    OpenAI in Anthropic odpirata vrata nadzoru: toda kdo bo nadziral nadzornike?

    Meta razvija AI-očala brez kamere: manj nadzora, več umetne inteligence

    Add A Comment
    Leave A Reply Cancel Reply

    Sorodna Objava

    Treble z 18 milijoni dolarjev uči umetno inteligenco poslušati resnični svet

    September 17, 2026

    Ko AI postane sodelavec: kdo bo v startupu še sprejemal odločitve?

    September 17, 2026

    Snapova očala za 2.200 dolarjev stavijo na AI, ki naj bi vedela, kaj potrebujete prej kot vi

    September 17, 2026

    Al Gore: Pravo tveganje umetne inteligence niso podatkovni centri, ampak modeli sami

    September 17, 2026

    OpenAI in Anthropic odpirata vrata nadzoru: toda kdo bo nadziral nadzornike?

    September 16, 2026

    Meta razvija AI-očala brez kamere: manj nadzora, več umetne inteligence

    September 16, 2026
    Kategorije
    • AI zakonodaja (53)
    • Generativna Umetna Inteligenca (1,157)
    • Orodja UI (155)
    • Splošno o umetni inteligenci (77)
    • UI Dogodki (40)
    • UI v podjetjih (18)
    • UI za grafike (3)
    • Uncategorized (21)
    Splošno o UI

    Kaj sploh je Akt o UI in zakaj je pomemben?

    Kalifornija prva uvaja stroga pravila za AI digitalne spremljevalce: kaj to pomeni za uporabnike in industrijo

    Bivši britanski premier Rishi Sunak svetovalec Microsofta in Anthropica pri oblikovanju AI politik

    Kalifornija uvaja prvi celovit zakon o varnosti umetne inteligence in izziva Evropo z novimi pravili

    Kategorije
    • AI zakonodaja (53)
    • Generativna Umetna Inteligenca (1,157)
    • Orodja UI (155)
    • Splošno o umetni inteligenci (77)
    • UI Dogodki (40)
    • UI v podjetjih (18)
    • UI za grafike (3)
    • Uncategorized (21)
    Najnovejše objave

    Huawei pospešuje prihod AI-čipa Ascend 960DT: lahko res ogrozi Nvidio?

    September 17, 2026

    AI startupi pred rokom za Disrupt 2026: tri dni za stik z vlagatelji in partnerji

    September 17, 2026

    AI agenta Instinct in Muse že kličeta namesto uporabnikov

    September 17, 2026
    Vse pravice pridržane seos.si | Theme: News Portal
    • O nas
    • Oglaševanje

    Type above and press Enter to search. Press Esc to cancel.