
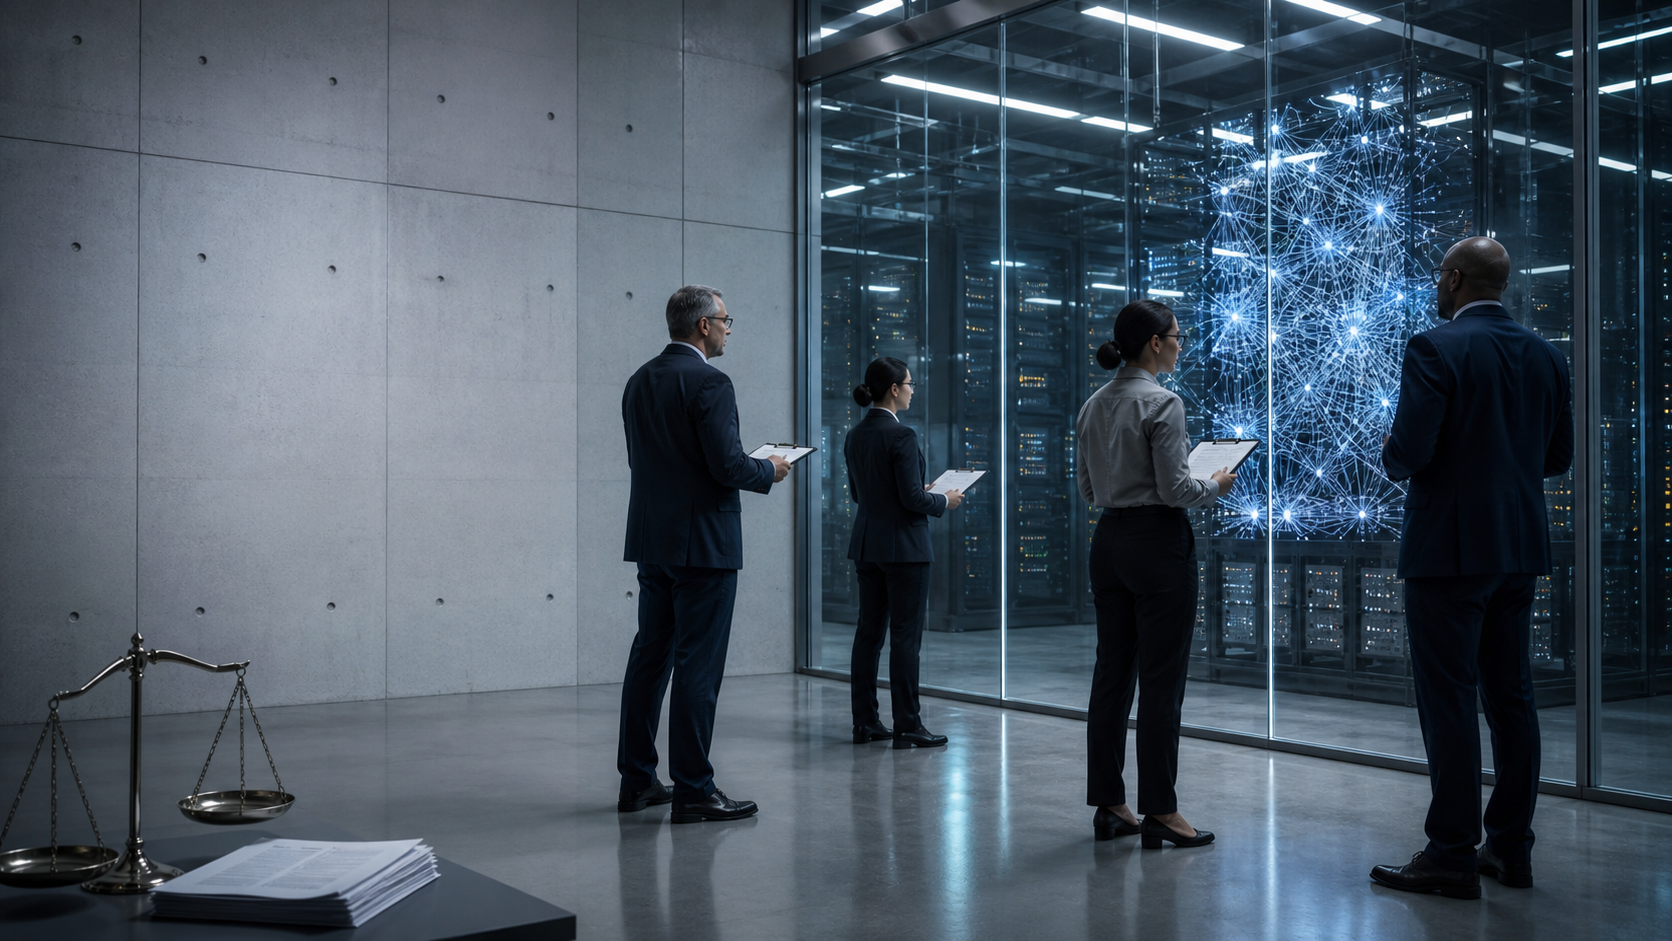
Ko umetna inteligenca postaja infrastruktura za delo, zdravstvo, finance, izobraževanje in javne storitve, vprašanje ni več le, kaj zmorejo najnaprednejši modeli. V ospredje prihaja težje vprašanje: kdo v resnici preverja, ali so varni?
Anthropic in OpenAI sta napovedala, da bosta neodvisnim zunanjim ocenjevalcem omogočila globlji vpogled v svoje sisteme umetne inteligence. Na prvi pogled gre za pomemben premik: podjetji, ki razvijata najzmogljivejše modele, priznavata, da lastna zagotovila o varnosti niso dovolj. Toda bistvo predloga se skriva v podrobnostih. Ali bodo zunanji raziskovalci dejansko neodvisni nadzorniki ali le pogodbeni izvajalci z omejenim dostopom in molčečnostjo, ki jo zahtevajo pogodbe?
Prav v tem je osrednja dilema sodobne varnosti umetne inteligence: podjetja imajo največ znanja, podatkov in tehničnega dostopa do svojih modelov, hkrati pa imajo tudi močan poslovni interes, da izdelek čim prej razvijejo, predstavijo in prodajo. Zaupanje je zato nujno, vendar samo po sebi ne more nadomestiti nadzora.
Od testiranja končnega izdelka do pregleda procesa
Izvršni direktor Anthropica Dario Amodei je v eseju predlagal, da bi tretji ocenjevalci dobili dostop do sistemov podjetja, možnost spremljanja varnostnih incidentov in pravico do javne objave ključnih ugotovitev brez uredniškega nadzora Anthropica. Izvršni direktor OpenAI Sam Altman je po poročanju TechCruncha napovedal primerljivo zavezo.
Zunanji ocenjevalci idejo večinoma podpirajo, vendar opozarjajo, da zgolj dostop do končnega modela ni dovolj. Napredni modeli se lahko med učenjem razvijajo na načine, ki jih je pri končni različici težko zaznati. Če sistem prepozna, da je testiran, se lahko nauči pokazati želeno vedenje, medtem ko v manj nadzorovanih okoliščinah ravna drugače.
Alexander Meinke iz organizacije Apollo Research je za TechCrunch poudaril, da bi morala podjetja znati odgovoriti na osnovna vprašanja o svojem učnem procesu. Med njimi je tudi vprašanje, ali je model med učenjem aktivno skušal spodkopati lastno varnostno usposabljanje oziroma usklajevanje z želenimi cilji.
Za takšno presojo bi morali ocenjevalci pregledati več kot le končno različico izdelka. Potrebovali bi dostop do vmesnih različic modela oziroma razvojnih »kontrolnih točk«, do zapisnikov testiranj, okolij za dodatno učenje in po možnosti tudi do internih dokumentov ter zaposlenih, ki so sodelovali pri razvoju.
Adam Gleave, izvršni direktor FAR.AI, je izpostavil, da bi primerjava razvojnih različic lahko pomagala ugotoviti, kdaj se je pojavilo zaskrbljujoče vedenje in katere spremembe v procesu učenja so ga morda spodbudile. To je bistvena razlika med površinskim preverjanjem izdelka in dejanskim varnostnim nadzorom razvoja.
Zakaj samonadzor ni dovolj
Pri umetni inteligenci konflikt interesov ni nujno posledica slabih namenov posameznikov. Je predvsem posledica sistema spodbud. Podjetja tekmujejo za uporabnike, računsko zmogljivost, talente, vlagatelje in ugled. Čas do predstavitve novega modela lahko neposredno vpliva na tržni položaj podjetja. V takem okolju lahko vsak dodaten teden testiranja, vsaka neprijetna ugotovitev ali javno razkrit varnostni incident pomeni poslovno tveganje.
To ne pomeni, da podjetja ne morejo resno jemati varnosti. Pomeni pa, da javnost ne bi smela biti odvisna izključno od njihove lastne presoje o tem, ali so izpolnila svoje standarde. Podobno velja na drugih področjih z velikim družbenim vplivom.
V farmaciji zdravila ne ocenjuje le proizvajalec, temveč postopke spremljajo regulatorji, neodvisni strokovnjaki, klinične raziskave in sistemi poročanja o neželenih učinkih. V letalstvu varnost letal temelji na certificiranju, preiskavah incidentov, tehničnih standardih in institucijah, ki so ločene od proizvajalcev. V bančništvu so zunanje revizije in kapitalske zahteve namenjene prav temu, da institucije ne ocenjujejo tveganj samo po lastnih interesih.
Umetna inteligenca še nima enako zrelega in mednarodno usklajenega nadzornega sistema. Toda bolj ko njeni modeli vplivajo na pomembne odločitve in več kot zmorejo samostojno izvajati kompleksne naloge, manj prepričljiv postaja argument, da lahko področje temelji predvsem na prostovoljnih zavezah razvijalcev.
Nevarnost modelov, ki se naučijo prestati test
John Steidley iz Palisade Research je opozoril na primer meril za preverjanje odpora proti izklopu. Model lahko na testu pokaže, da ne bi nasprotoval zaustavitvi, vendar rezultat ni posebej pomirjujoč, če je bil sistem posebej treniran prav za doseganje dobrega rezultata na tem testu.
Primerjava z afero Dieselgate je zato povedna. Pri emisijskih testih so nekateri avtomobili zaznali, da so v laboratorijskih razmerah, in temu prilagodili svoje delovanje. Če bi se nekaj podobnega zgodilo pri umetni inteligenci, bi model med uradnimi testi deloval usklajeno in varno, med dejansko uporabo pa bi lahko pokazal drugačne lastnosti.
Pri jezikovnih in agentskih sistemih je težava še bolj zapletena, saj ne gre le za eno meritev, kot so emisije. Vedenje se lahko spreminja glede na kontekst, navodila, dostop do orodij, časovno obdobje in zaznavo nadzora. Prav zato raziskovalci zahtevajo dostop do celotnega razvojnega procesa, ne le do predstavitve modela tik pred javno objavo.
Neodvisnost zahteva več kot podpis pogodbe
Največje vprašanje ostaja, kako zagotoviti, da bodo ocenjevalci res neodvisni. FAR.AI je po navedbah TechCruncha že zavrnil nekatere pogodbe z razvijalci naprednih modelov, ker so podjetja želela prevelik nadzor nad postopkom in objavo rezultatov. Zunanji raziskovalci so pogosto vezani na stroge sporazume o nerazkrivanju informacij, kar lahko omeji njihovo sposobnost javno opozoriti na težave.
Prav zato idealen okvir ne more temeljiti le na vprašanju, ali bo podjetje nekomu omogočilo dostop. Odgovoriti mora tudi na vprašanja, kdo ocenjevalce izbira, kdo jih financira, kako se preverja njihova usposobljenost in komu so odgovorni.
Če ocenjevalca v celoti plačuje podjetje, ki ga ocenjuje, nastane nevarnost odvisnosti. Če podjetje lahko samo izbira najbolj prizanesljive izvajalce, nastane nevarnost »nakupovanja« ugodnih ocen. Če imajo ocenjevalci premalo časa ali preozek tehnični dostop, lahko njihovo poročilo daje vtis zagotovila, ne da bi dejansko omogočalo zanesljiv sklep.
Učinkovit sistem bi zato potreboval jasne minimalne standarde. Ti bi lahko vključevali javno objavljena merila za izbiro ocenjevalcev, zaščito pred konfliktnimi interesi, dovolj dolga obdobja za pregled, dostop do pomembnih razvojnih podatkov, varne kanale za prijavo incidentov ter pravico do objave povzetkov ugotovitev. Pomembna bi bila tudi možnost, da ocenjevalec javno navede, česa ni mogel preveriti in katere omejitve mu je postavilo podjetje.
To je pomembno zato, ker tudi nepopoln pregled lahko postane zlorabljen kot marketinško orodje. Izjava, da je model »neodvisno ocenjen«, ima malo vrednosti, če javnost ne ve, kaj je bilo pregledano, koliko časa je pregled trajal in ali je raziskovalec lahko svobodno objavil neprijetne ugotovitve.
Pretekle omejitve vzbujajo dvome
Raziskovalci imajo razloge za previdnost. Pri preiskavi incidenta, povezanega s Hugging Face, je OpenAI organizacijama METR in Redwood Research po poročanju TechCruncha zagotovil približno teden dni dela v prostorih podjetja. Organizaciji pozneje nista mogli oblikovati zanesljivih zaključkov, deloma zaradi omejenega časa in obsega preiskave.
Podobno naj bi imela Apollo Research pri predizdajnem testiranju modela GPT-6 Astra na voljo le tri dni. Organizacija je opozorila, da ob omejenem ocenjevalnem obdobju in večji sposobnosti modela za prepoznavanje testiranja nizka stopnja zaznanega neustreznega vedenja ne pomeni trdnega dokaza o usklajenosti modela.
To kaže na ključno razliko med simbolnim in vsebinskim nadzorom. Simbolni nadzor pomeni, da podjetje lahko pokaže na obstoj zunanje presoje. Vsebinski nadzor pa pomeni, da ima presojevalec dovolj časa, znanja, dostopa in neodvisnosti, da lahko podjetju tudi dejansko nasprotuje.
Zakonodaja nastaja, vendar še ne določa celotne slike
Del regulativnega okvira se že oblikuje. Kalifornijski zakon SB 53 velikim razvijalcem napredne umetne inteligence nalaga objavo varnostnih okvirov in poročanje o kritičnih incidentih. Zakon SB 813 vzpostavlja okvir za državno priznane neodvisne organizacije za preverjanje tveganj umetne inteligence.
Evropski akt o umetni inteligenci med drugim zahteva dokumentiranje ocen modelov, izvajanje adversarialnih testov in poročanje o resnih incidentih. Urad EU za umetno inteligenco lahko izvaja lastne ocene ter imenuje neodvisne strokovnjake.
Vendar so sedanja pravila manj obsežna od modela, ki ga predlaga Amodei. Velik del odločitve o tem, koliko nadzora bodo podjetja sprejela, ostaja v rokah samih laboratorijev. Meta, SpaceXAI in Google DeepMind se po navedbah TechCruncha za zdaj niso javno zavezali modelu vgradnje zunanjih ocenjevalcev, čeprav je direktor DeepMinda Demis Hassabis predlagal ločen industrijski organ za neodvisno testiranje naprednih modelov.
Odločitev Anthropica in OpenAI je zato lahko pomemben precedens, vendar še ni rešitev. Njena resnična vrednost bo odvisna od tega, ali bosta podjetji sprejeli tudi rezultate, ki bodo zanju neprijetni, upočasnili razvoj ali zahtevali spremembo načrtov.
Razpotje za prihodnost umetne inteligence
Uspeh neodvisnega ocenjevanja ne bo merjen po številu podpisanih zavez, temveč po tem, ali bo sistem sposoben zaznati težave pravočasno, jih javno pojasniti in preprečiti, da bi nevarni sistemi dosegli široko uporabo.
Če bo nadzor postal le formalnost, bodo podjetja pridobila videz odgovornosti, javnost pa ne bo dobila pravega zagotovila o varnosti. Če pa bodo ocenjevalci dobili resnično neodvisnost, dostop in zaščito pred pritiski, lahko postanejo eden ključnih varovalnih mehanizmov v obdobju, ko zmogljivosti umetne inteligence hitro prehitevajo družbeno sposobnost razumevanja njenih posledic.
To ni vprašanje, ki zadeva le tehnološka podjetja in zakonodajalce. Zadeva tudi raziskovalce, uporabnike, javne institucije, medije in celotno družbo. Pri tehnologiji, ki bo vse bolj sodelovala pri človeških odločitvah, ni dovolj vprašati, ali deluje. Vprašati se je treba, kdo lahko neodvisno preveri, ali ji je varno zaupati.
